Bioinfoysis:面向长程生物信息学分析的多智能体框架
一个持久化、以分析产物为依据的分析执行框架,融合自适应规划、受规范约束的技能与受控执行,在 BixBench 上达到当前最优的准确率。
摘要
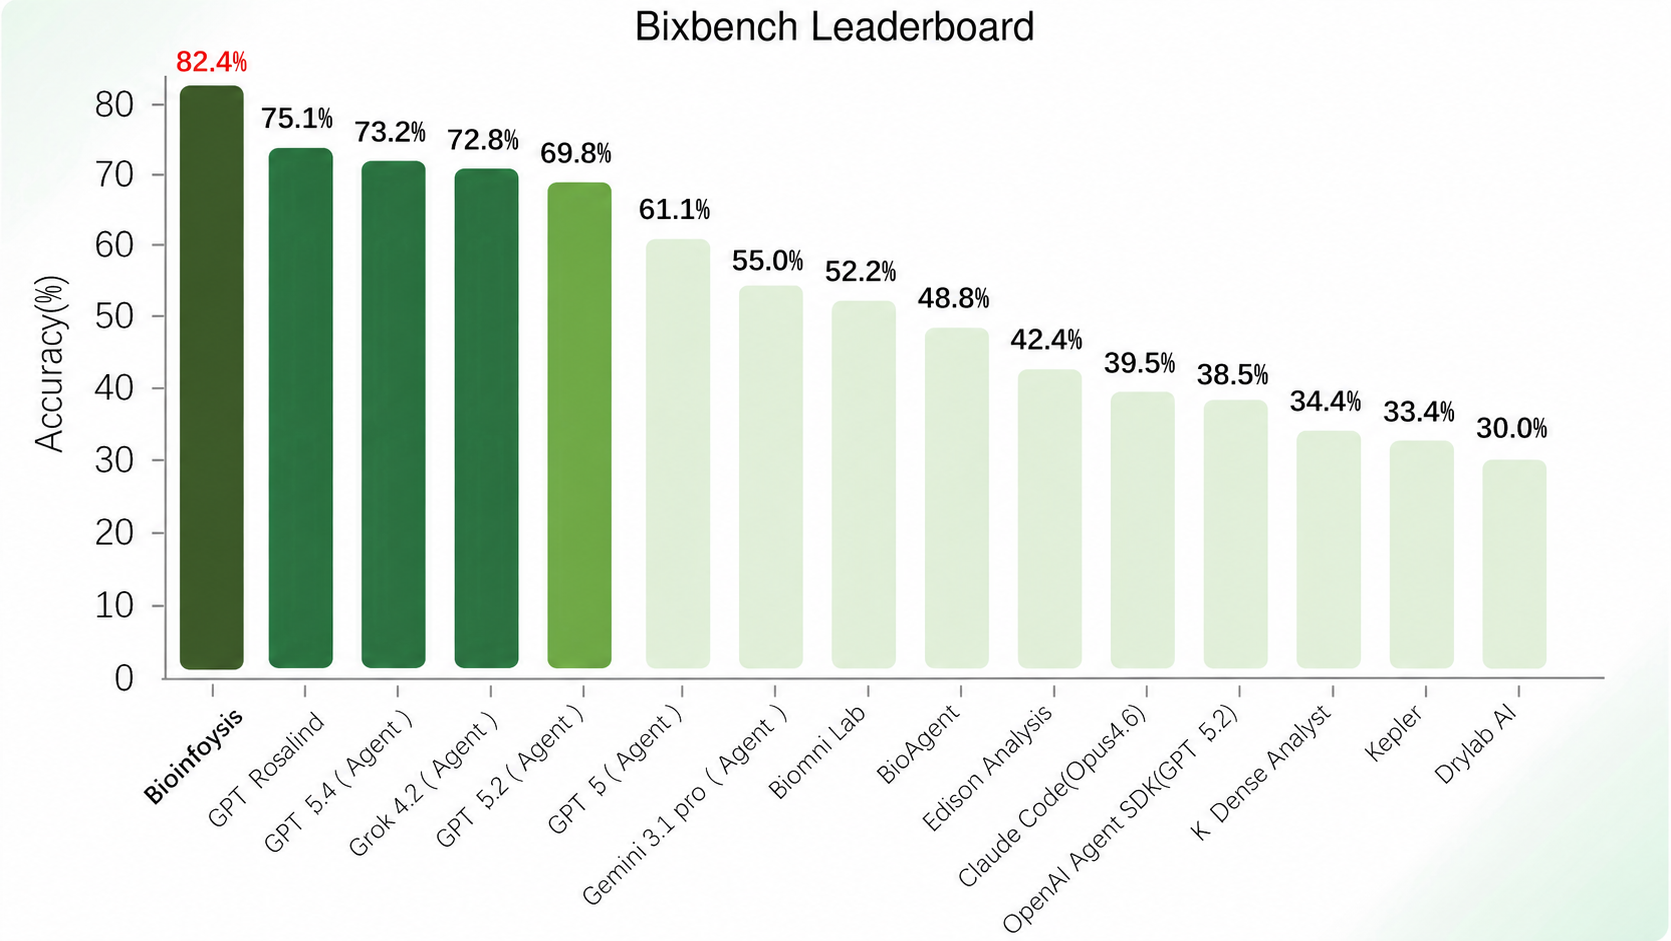
Bioinfoysis 是一个多智能体执行框架,将每个请求表示为一个持久化、以分析产物为依据的分析运行。它结合全局规划与逐步、证据驱动的重新规划,通过结构化交接协调专业智能体,并保留检查、恢复或验证分析所需的全部中间产物、执行轨迹与决策。在 BixBench 上,Bioinfoysis 取得了当前最优的 82.4% 准确率。在 LAB-Bench2 的四种底层语言模型上,该框架将 SeqQA2 的平均准确率从 41.65% 提升至 69.69%,将 DbQA2 的平均准确率从 3.13% 提升至 27.60%。
为什么生物信息学需要受规范约束的执行框架
现代生物信息学分析天然具有长程特征:一个请求可能需要跨越多个相互依赖的步骤,完成数据检查、工具选择、统计建模、代码执行与结果解读。通用语言模型能够对单个步骤进行推理,却难以在持续数小时的分析中保持连贯——中间结果可能丢失,工作流程可能偏离目标,输出也可能变得无法验证。
Bioinfoysis 通过受规范约束的执行框架应对这些问题。系统将每次分析作为独立、持久化的运行进行管理;评价其质量时,既关注最终答案,也关注得到答案的过程能否执行、检查、恢复和验证。这一设计由以下五项能力构成:
- 协同式多智能体分析——为规划、研究、编码和报告设置专业角色,并通过结构化交接进行协调。
- 以证据为依据、以技能为规范的执行——结论必须由实际执行的代码和经过验证的分析产物支持;生物信息学技能则将符合领域规范的流程编码为可复用程序。
- 按角色定制的上下文与持久记忆——每个智能体获得适合其角色、兼顾上下文预算的运行视图,并共享有证据支持的跨运行记忆。
- 结构化交接与分析产物的连续传递——结果在传递给后续步骤时,保留其来源、相关产物和不确定性。
- 基于执行轨迹的审计与评估——记录每次调用、工具使用和失败,以支持审计与恢复。
三层架构,五类角色
系统由三层组成:编排层维护自适应计划与检查清单;科学能力与执行层提供工具、受规范约束的技能、隔离的代码执行和分析产物验证;可观测性层记录执行轨迹、分析统计和审计记录。
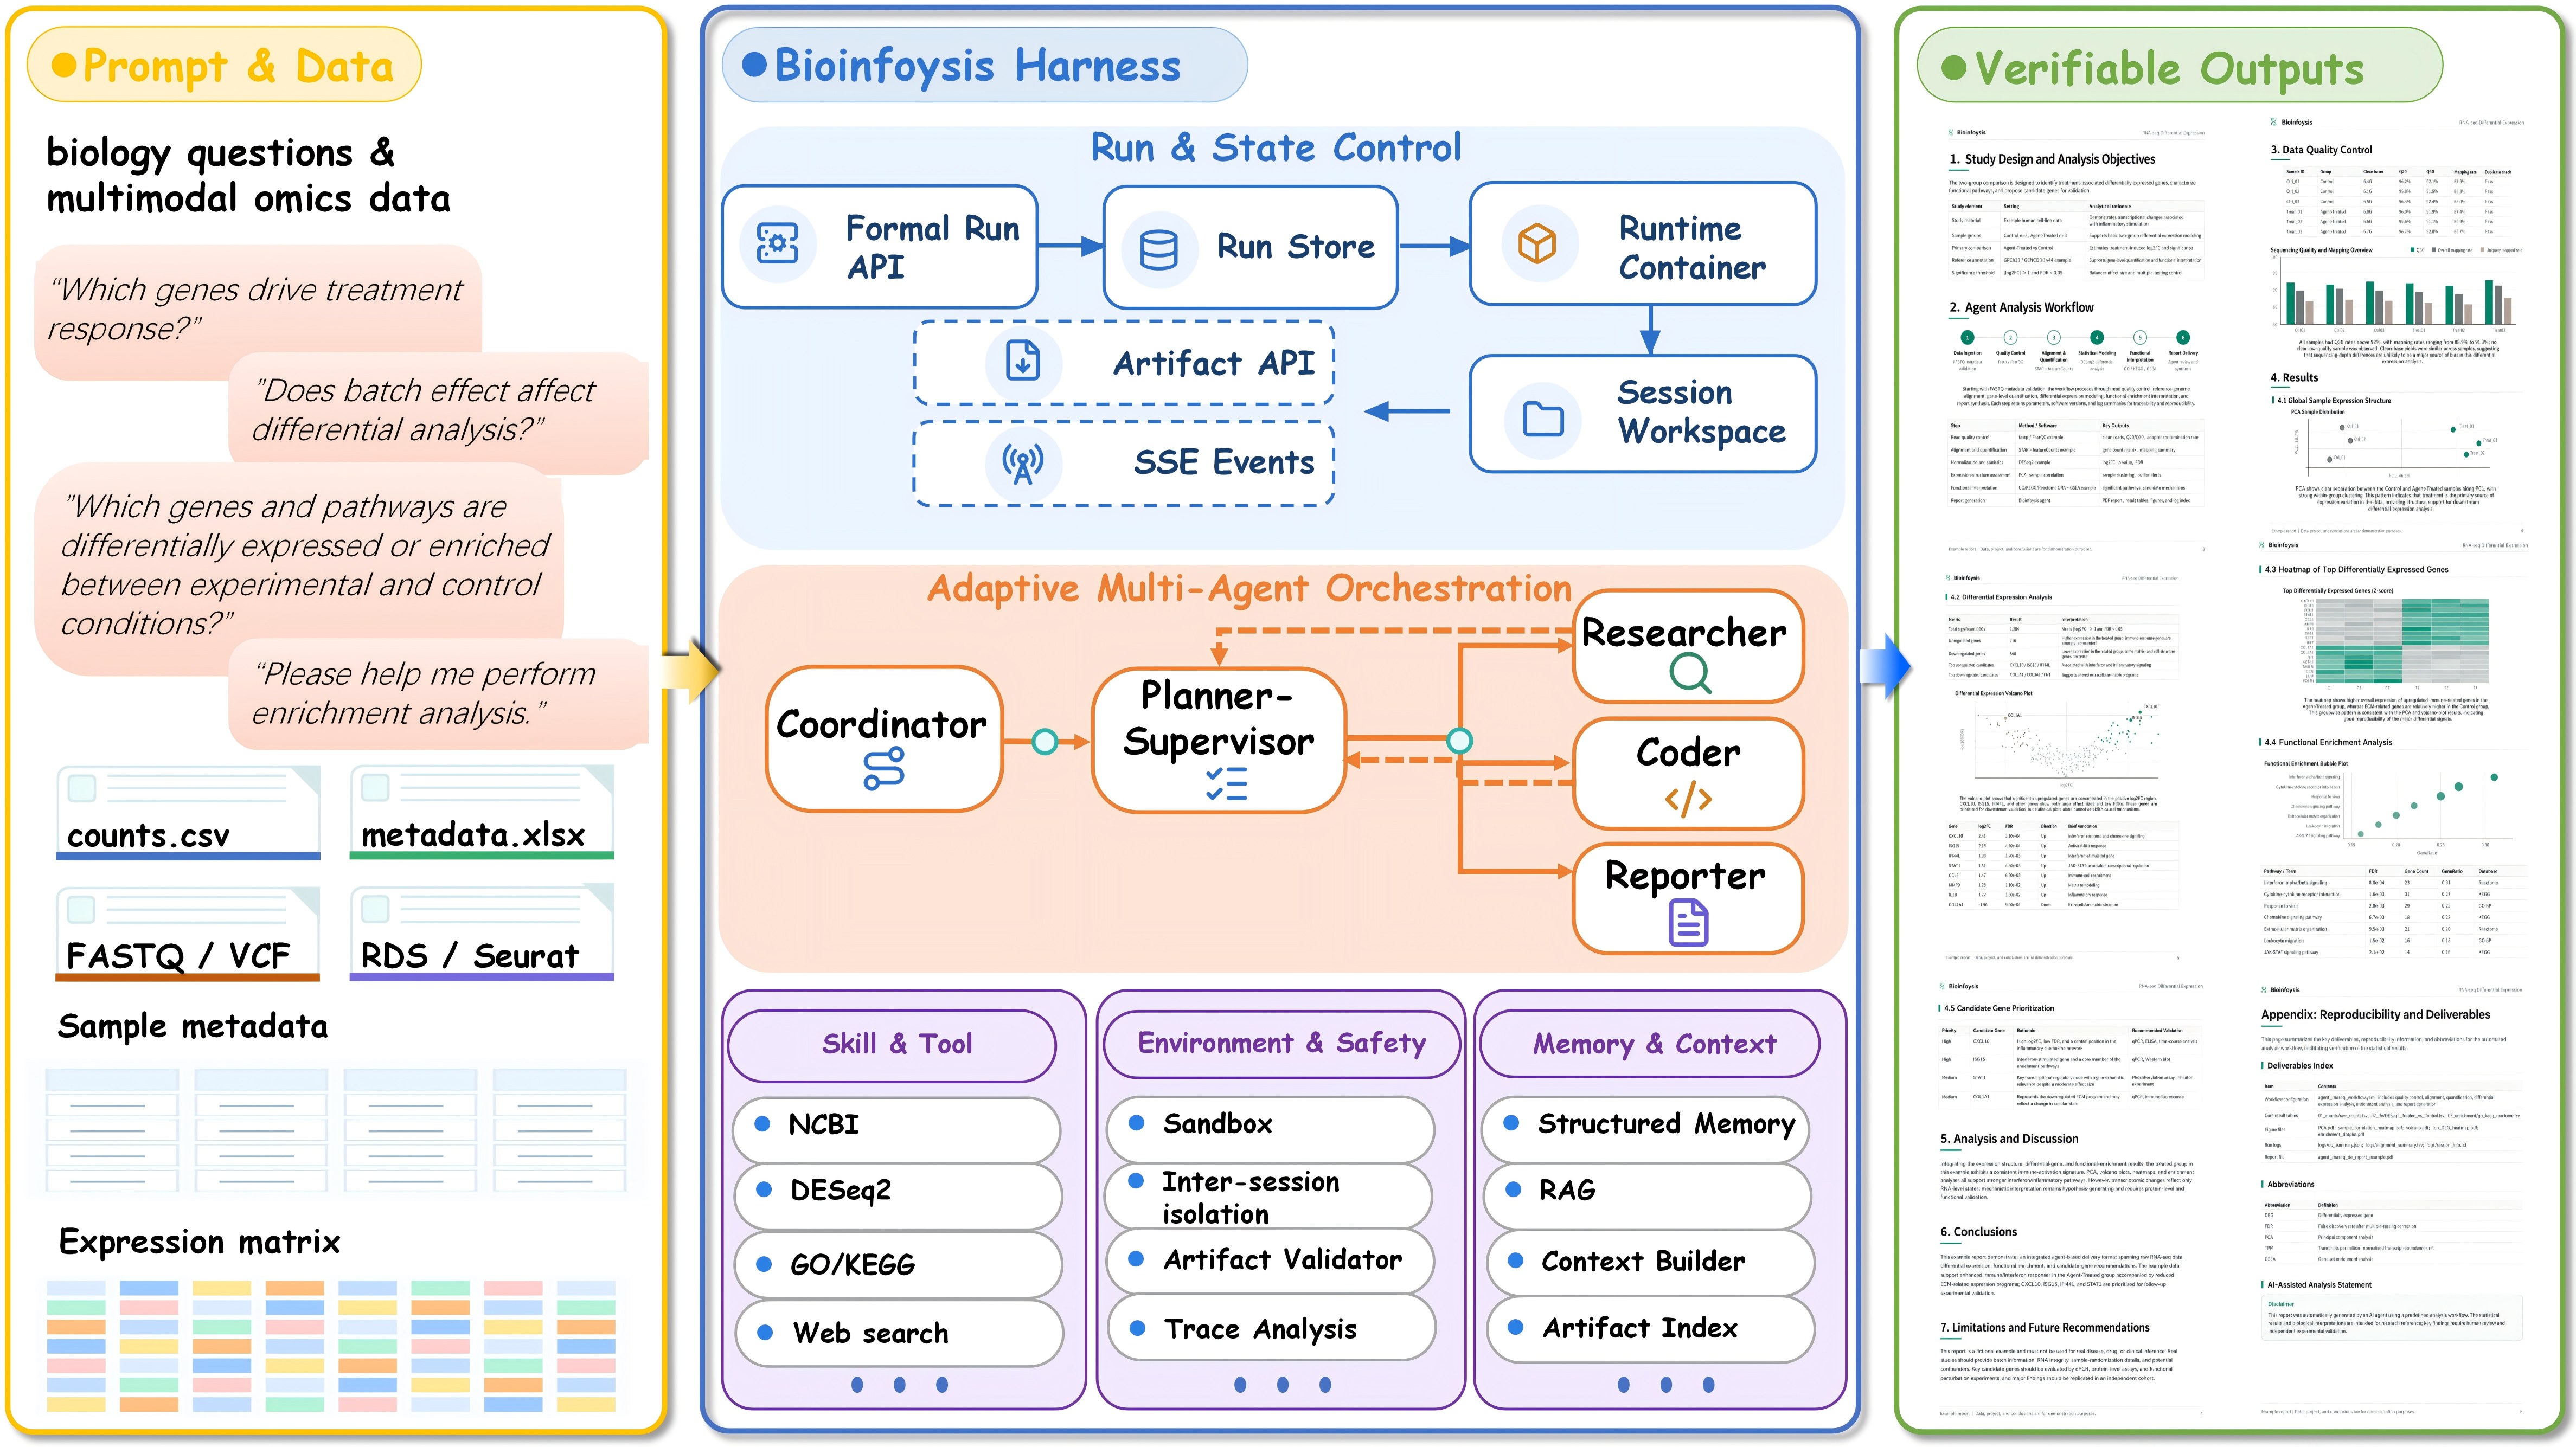
点击查看大图
自适应规划
Bioinfoysis 在每个步骤后都可重新规划,而非采用固定的“先规划、后执行”流程。规划者先给出全局计划,再根据陆续产生的中间结果修订剩余检查清单。统计检验失败、意外的数据结构或相互矛盾的发现,都可能触发有边界、由证据驱动的重新规划,避免盲目继续执行。
受规范约束的技能与工具
领域正确性被编码为技能:可复用、可进行版本管理的流程,例如差异表达分析、富集分析、变异检测和质量控制。这些技能明确适用的输入、前提假设和预期产物,使编码智能体遵循科学上合理的工作流程,而非临时拼凑脚本。
持久化运行与基于分析产物的执行
持久化运行与受控执行
每次分析均以持久化运行的形式存储,具有稳定的标识符、已登记的输入、工作流状态、有序事件历史和分析产物索引。各次运行在专属工作空间内执行,改变状态的操作按顺序串行进行,避免并发分析互相覆盖。中断的运行可以在同一标识符下,从有效检查点继续。
按角色定制的上下文与持久记忆
系统不会将完整对话塞进每一个提示词。不同角色获得各自需要的视图:规划者看到任务与检查清单,编码者看到当前步骤和相关输入,报告者看到经过验证的结果。大型工具输出存放在提示词之外,通过稳定的标识符引用;只有已完成运行中有证据支持的事实,才会被写入持久记忆。
基于分析产物的执行
生成的输出作为运行产物进行管理,而不仅是回复中提到的文件路径。报告所引用的脚本、表格和图像必须在获准的工作空间内解析定位,检查其是否真实存在,并按输出要求进行验证。在运行完成前,对外产物会冻结定稿,并以内容哈希建立索引;如果必需的交付物无法发布,该运行就不会被报告为成功。
执行轨迹、审计与恢复
系统向用户提供经过脱敏处理的公开事件流,同时在内部轨迹中记录智能体调用、工具使用、检索与失败。恢复以检查点为基础:发布操作和记忆更新受到保护,避免重复应用;取消操作则在安全的工作流边界停止,使运行仍可恢复。
系统质量不仅取决于答案本身,更取决于得到答案的过程能否执行、检查、恢复和验证。
BixBench 达到当前最优,LAB-Bench2 持续提升
我们采用互为补充的基准测试进行评估:BixBench包含 61 个真实分析任务包,覆盖约 20 个领域、共 205 道开放式问题,用于衡量端到端的可执行分析能力;在LAB-Bench2中,我们重点评估 SeqQA2(400 道题)和 DbQA2(86 道题),分别衡量序列分析推理与数据库检索能力。
BixBench:准确率 82.4%,位居第一
以 Kimi-K2.6 为底层智能体模型时,Bioinfoysis 在 205 道题中答对 169 道,比排名第二的 GPT Rosalind 高出 7.3 个百分点,分别比 GPT-5.4 Agent 和 Grok-4.2 Agent 高出 9.2 和 9.6 个百分点。与面向生物信息学的系统相比,它分别比 Biomni Lab 和 BioAgent 高出 30.2 和 33.6 个百分点。考虑到生物信息学中的分析规范可能影响结论,我们还额外审查代码执行的正确性、分析产物的生成及可追溯性;基准测试审计规程详见完整报告。
点击查看大图
| 领域 | 任务包数 | 答对数 | 题目数 | 准确率 |
|---|---|---|---|---|
| 功能基因组学与通路富集 | 9 | 22 | 31 | 70.97% |
| 基因组变异分析 | 7 | 14 | 16 | 87.50% |
| 转录组学与差异表达 | 10 | 30 | 42 | 71.43% |
| 系统发育与比较基因组学 | 15 | 45 | 51 | 88.24% |
| 表观基因组学 | 2 | 9 | 12 | 75.00% |
| 临床研究与生物统计学 | 3 | 16 | 18 | 88.89% |
| 生物成像与定量表型分析 | 4 | 21 | 21 | 100.00% |
| 单细胞转录组学 | 1 | 2 | 2 | 100.00% |
| 蛋白质组学 | 1 | 4 | 4 | 100.00% |
| 多组学整合与机器学习 | 1 | 2 | 2 | 100.00% |
| 微生物基因组学与抗微生物药物耐药性 | 1 | 4 | 6 | 66.67% |
| 总体 | 54 | 169 | 205 | 82.44% |
错误主要集中在功能基因组学(70.97%)和转录组学(71.43%):36 道答错的题目中,有 21 道来自这两个领域。这类任务中的决策相互依赖,例如样本选择、模型设定和标识符转换,因而早期错误可能传递到后续步骤。题目较少的类别(2–4 道题)取得 100% 的结果,不应被解读为相关能力已得到全面解决。
LAB-Bench2:四种模型均获得显著且稳定的提升
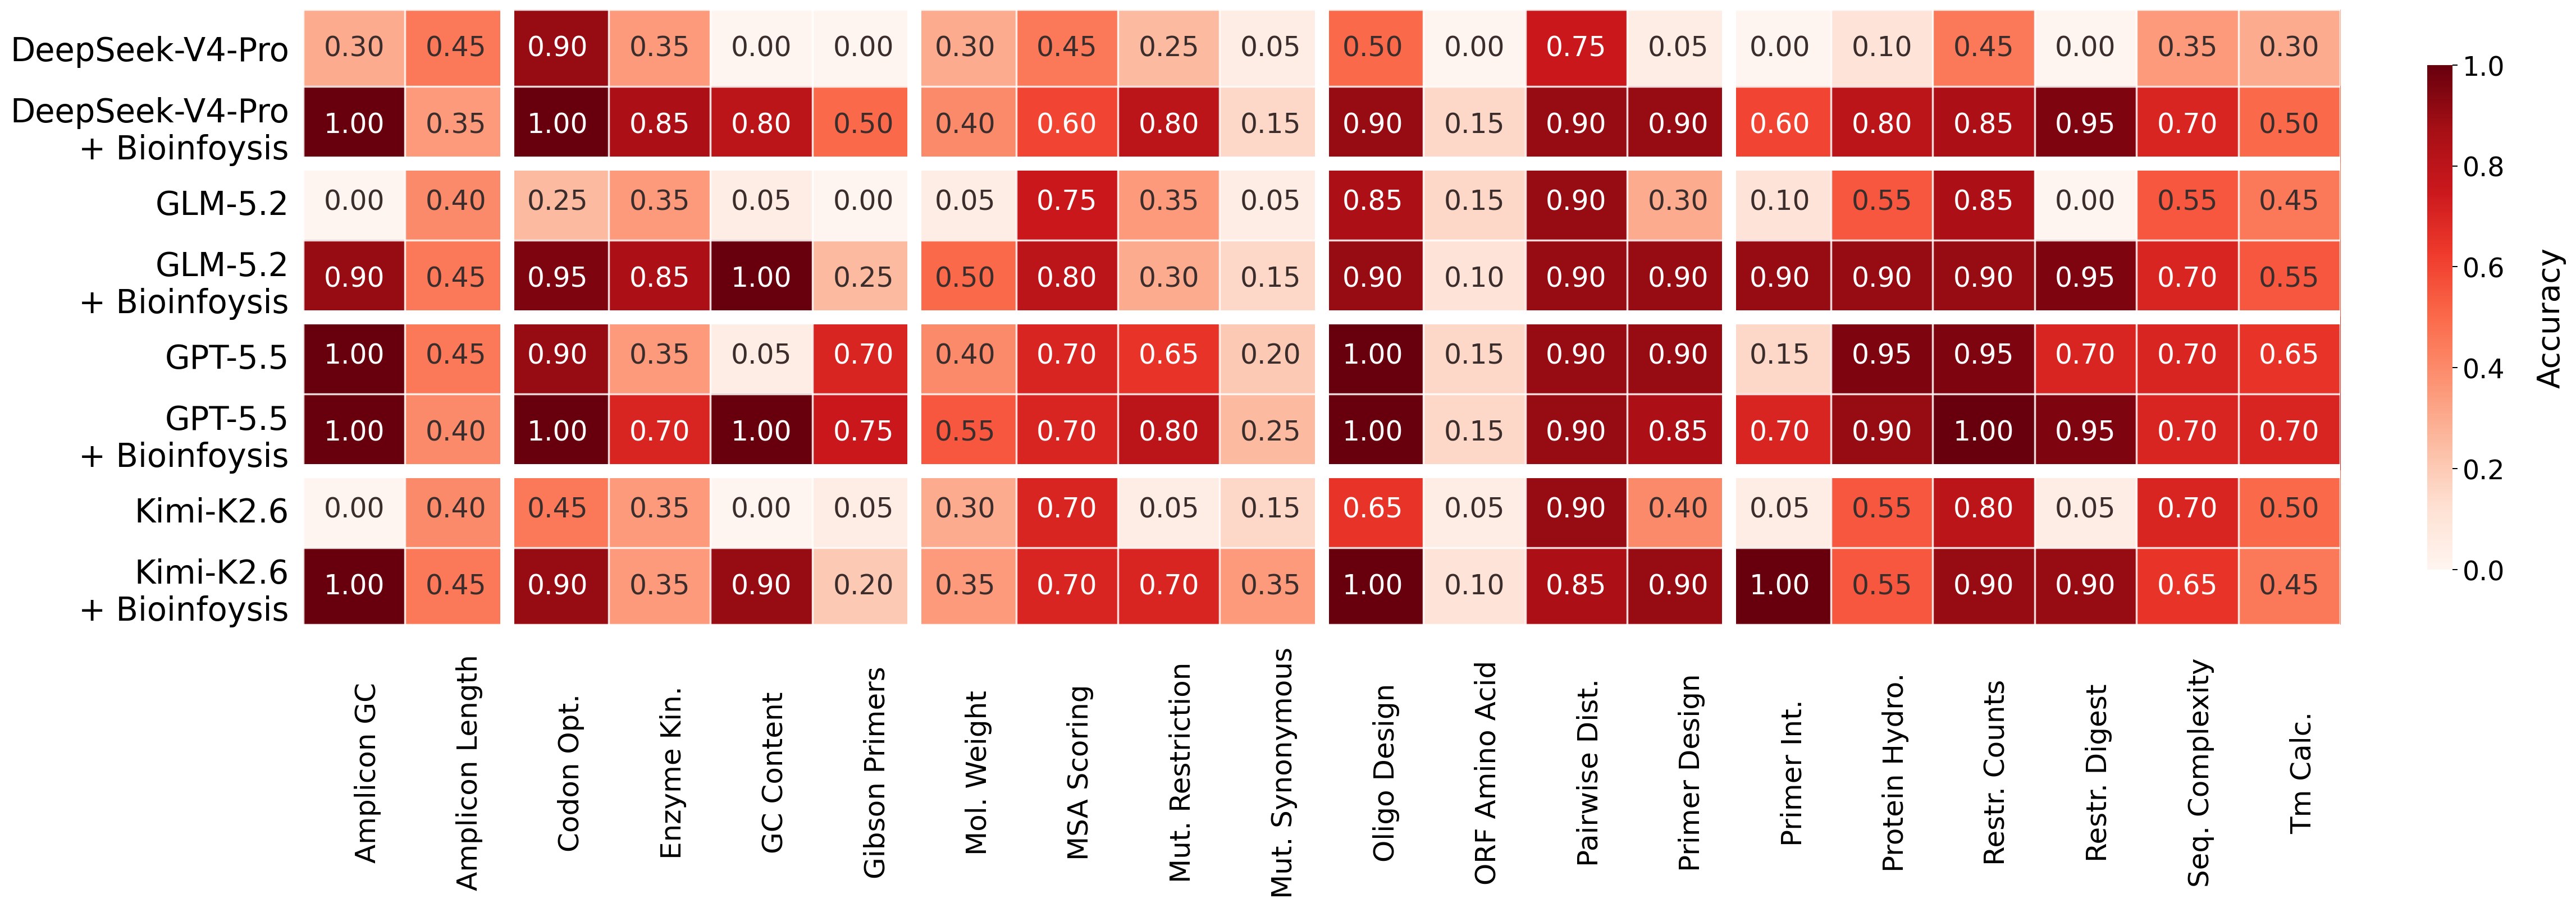
在 SeqQA2 上,Bioinfoysis 提升了所有受测模型的表现,其中 Kimi-K2.6、DeepSeek 和 GLM 分别提高 30.50、36.89 和 34.50 个百分点。许多序列分析问题可以转化为确定性操作,该框架会将这些操作拆解为明确、可执行的步骤。直接推理在 DbQA2 上的难度明显更高,基础模型的平均准确率仅为 3.13%;Bioinfoysis 则通过完成“检索—处理—作答”的完整流程,将平均准确率提升至 27.60%。
| 基准测试 | 系统 | Kimi-K2.6 | GPT-5.5 | DeepSeek | GLM-5.2 | 平均值 |
|---|---|---|---|---|---|---|
| SeqQA2(400 道题) | Bioinfoysis | 66.00% | 75.00% | 68.50% | 69.25% | 69.69% |
| SeqQA2(400 道题) | 基础模型 | 35.50% | 64.75% | 31.61% | 34.75% | 41.65% |
| DbQA2(86 道题) | Bioinfoysis | 30.20% | 37.20% | 22.10% | 20.90% | 27.60% |
| DbQA2(86 道题) | 基础模型 | 1.60% | 7.80% | 3.10% | 0.00% | 3.13% |
SeqQA2 使用 Kimi-K2.6、GPT-5.5、DeepSeek-V4-Pro 和 GLM-5.2。DbQA2 中报告的 DeepSeek 基础模型为 DeepSeek-V4-Flash,因此该列属于系统层面的对比,而非底层模型严格一致的对比。
点击查看大图
消融实验:记忆与技能贡献最大
在采用 GPT-5.4、评估全部 205 道 BixBench 题目的实验中,移除持久记忆使准确率下降 22.44 个百分点,移除生物信息学技能使准确率下降 19.02 个百分点,这两者是最主要的贡献来源。ReAct 式规划带来 6.83 个百分点的贡献;移除全部技能后,准确率降至 42.44%。该框架也能迁移到不同模型,在 Kimi-K2.6、GPT-5.4 和 DeepSeek-V4-Pro 上保持 77–82% 的准确率。
| 配置 | 智能体模型 | 技能数 | 准确率 | 答对数 | 准确率变化 |
|---|---|---|---|---|---|
| Bioinfoysis(完整配置) | Kimi-K2.6 | 78 | 82.44% | 169/205 | +3.41 |
| Bioinfoysis(完整配置) | GPT-5.4 | 78 | 79.02% | 162/205 | 0.00 |
| Bioinfoysis(完整配置) | DeepSeek-V4-Pro | 78 | 77.07% | 158/205 | −1.95 |
| 移除 ReAct 式规划 | GPT-5.4 | 78 | 72.20% | 148/205 | −6.83 |
| 移除记忆 | GPT-5.4 | 78 | 56.59% | 116/205 | −22.44 |
| 移除生物信息学技能 | GPT-5.4 | 30 | 60.00% | 123/205 | −19.02 |
| 移除全部技能 | GPT-5.4 | 0 | 42.44% | 87/205 | −36.59 |
作者名单与致谢
核心贡献者
Qingyang Shao, Xin Zhang, Zhouyang Yuan, Xianying Chen.
贡献者
Yujia Xiang, Zihao Yang, Tong Ye, Yangqi Zhang, Jiakang Xu, Xiaoqing Yan, Xuan Luo, Keyi Li, Enci Fan, Kai Kang, Zhuohan Liu, Xingyu Jin, Chunran Teng, Tao Li, Xinyu Lv*, Minghui Wang*, Wenfeng Li*, Yidan Gao*, Siyu Liu, Mingrui Luo, Zhu Liang.
项目负责人
Guanren Qiao (guanrenqiao1@link.cuhk.edu.cn), Zhiping Xu (zhiping_xu@dascience.cn).
* 表示目前已离开团队的成员。
引用 Bioinfoysis
如果 Bioinfoysis 对你的研究有所帮助,请引用本报告:
@article{shao2026bioinfoysis,
  title   = {Bioinfoysis: A Multi-Agent Framework for Long-Horizon
             Bioinformatics Analysis},
  author  = {Shao, Qingyang and Zhang, Xin and Yuan, Zhouyang and
             Chen, Xianying and others},
  journal = {arXiv preprint},
  year    = {2026}
}